ブログ

  • Feature-Sliced Design(FSD)をプロダクトに導入しての振り返り

    Feature-Sliced Design(FSD)をプロダクトに導入しての振り返り

    現在開発しているプロダクトでは、フロントエンドのアーキテクチャに Feature-Sliced Design(FSD) を採用しています。

    フロントエンドの開発を進めていくと、アプリの規模が大きくなるにつれてコンポーネントの肥大化や依存関係の複雑化に必ず直面すると思います。気づけばどこからでも何でも呼べるスパゲッティコードになってしまい、コードを1箇所いじると予期せぬ場所が壊れる……というのは、多くのチームが経験しているのではないでしょうか。

    私たちのチームでも、こうしたディレクトリ迷子や循環依存を防ぎ、スケールしても壊れにくい基盤を作るためにFSDを導入しました。FSDについて紹介しつつ、実際に現場で運用してみてわかったFSDの構造や、具体的なメリット・現実的な課題について振り返ります。

    Feature-Sliced Design(FSD)とは

    FSDは、ReactやVue、Next.jsなどのコンポーネントベースのフロントエンド向けに作られたアーキテクチャモデルです。

    一言でいうと、レイヤー(階層)とスライス(機能)の2つの軸でコードを整理し、上から下への単方向の依存関係を絶対ルールとして強制する仕組みです。

    かつて流行したAtomic Designなどは、コンポーネントの見た目の大きさや役割で分類していました。しかしこれだと、ユーザーや商品といった、特定の業務ドメインに紐づくロジックをどこに置くべきかが曖昧になりがちでした。

    FSDは、技術的な関心事(UI、API、状態管理)だけでなく、ビジネスドメイン(機能)の単位でコードを切り出すことで、パーツごとの独立性を高めます。

    FSDを形作る3つの概念:Layers, Slices, Segments

    FSDのディレクトリは、上から順に以下の3つの階層で成り立っています。

     ① Layers(レイヤー)

    アプリ全体を役割ごとに縦に分割したものです。FSDでは標準で7つのレイヤーが定義されており、上のレイヤーは、自分より下のレイヤーにしか依存してはいけないという厳格なルールがあります。

    下に行くほど汎用的(技術的)になり、上に行くほど具体的(ビジネスルールに密着したもの)になります。
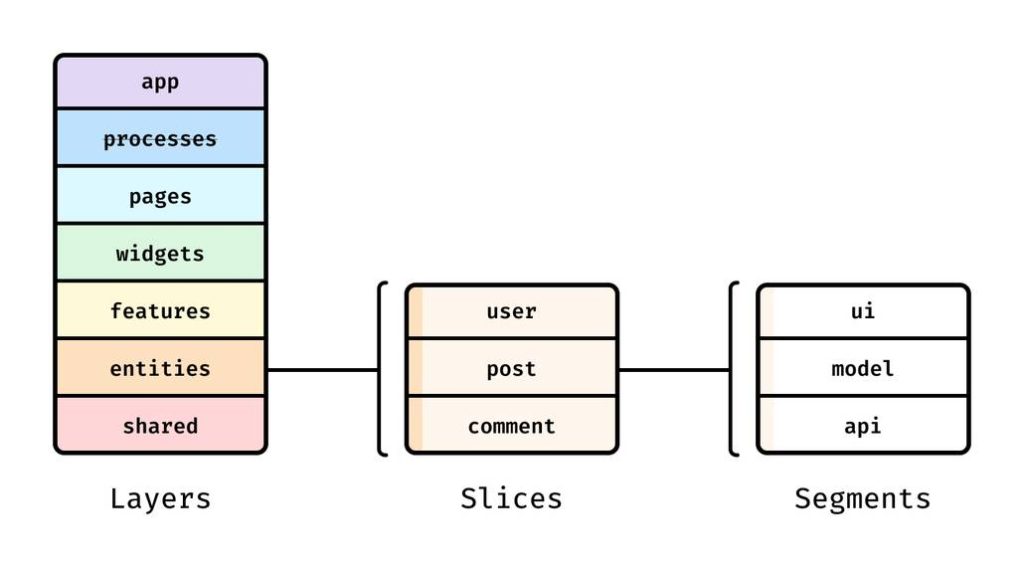
    • app: アプリ全体の初期化、グローバルスタイル、プロバイダーの設定など。
    • processes: 複数のページにまたがる複雑なビジネスプロセス(認証フローや段階的なフォーム入力など)※現在は設計をシンプルに保つため、非推奨とされるケースも増えているようです。私たちも今回は作成しませんでした。
    • pages: 画面(ルート)単位のコンポーネント。
    • widgets: 画面を構成する、独立した大きめのUIブロック(例:ヘッダー、サイドバーなど)
    • features: ユーザーに価値を提供する「アクション(機能)」の単位。ビジネスロジックを含み、何かを操作するもの(例:カートに追加する、お気に入り登録する)。
    • entities: ビジネス上の実体(ドメイン)。データモデルや、そのデータに紐づく最小限のUI(例:商品カードの見た目、ユーザー情報の表示)。
    • shared: 特定のドメインに依存しない、純粋な共通モジュール(例:UIコンポーネントライブラリ、APIクライアント、日時フォーマッター)。

     ② Slices(スライス)

    pages、widgets、features、entities の中に作られる、ビジネスドメインごとのディレクトリです。例えば、entities レイヤーの中に user や productというスライスを作ります。

    ここで最も重要なルールがあります。

    同じレイヤー内のスライス同士は、お互いをインポートしてはいけない。

    なじみ深いECサイトを例にすると、features/add-to-cart(カート追加機能)が features/wishlist(お気に入り機能)を直接参照することは禁止です。これによって、機能同士の結合度が下がります。

    ③ Segments(セグメント)

    スライスの内部を、技術的な役割でさらに細分化したものです。通常は以下の4つに整理されます。

    • ui: コンポーネント(React/Vueファイルなど)
    • model: 状態管理(Reduxなど)、Hooks、ビジネスロジック
    • api: 外部APIとの通信処理
    • lib: そのスライス内だけで使うユーティリティ関数

    ディレクトリ構造の具体例

    Next.jsやViteプロジェクトでFSDを採用した場合、以下のような配置になります。

    src/
    ├── app/                  # アプリ全体のグローバル設定
    │   └── providers/
    ├── pages/                # 各画面のルーティング表現
    │   └── catalog/
    ├── widgets/              # 複数機能をまとめる大きなUIブロック
    │   └── product-grid/
    ├── features/             # アクションを伴う「機能」単位
    │   └── add-to-cart/
    │       ├── ui/           # カート追加ボタンなど
    │       ├── model/        # カート追加時のロジックや状態
    │       └── index.ts      # 外部に公開する窓口(Public API)
    ├── entities/             # ドメインモデルと最小限のUI
    │   ├── product/
    │   └── user/
    └── shared/               # ドメインに依存しない共通部品
        ├── ui/               # 汎用Button, Inputなど
        └── api/              # 共通のAPIクライアント
    

    Public API(index.ts)について

    FSDの運用で外せないのが、各スライスのルートに置く index.ts です。これを Public API と呼びます。スライスの内部(ui や model の深い階層)にあるファイルを、外部から直接インポートすることは禁止です。必ずこの index.ts からエクスポートされたものだけを経由して使います。これによって内部の実装をいくらいじっても、外部への影響を最小限に抑え込めます。

    プロダクトに導入して感じたメリット

    コードを置く場所に迷わなくなり、レビューコストが下がる

    ビジネスロジックがあってユーザーのアクションをトリガーするなら features、純粋にデータを表示するだけなら entities、というように基準が明確であるため、新規コンポーネント作成時に置き場所に迷うことが少なくなりました。レビュワーも設計の意図を掴みやすいです。

    依存関係が綺麗になり、リファクタリングが楽になる

    「上から下」という単方向の依存ルールと「同じレイヤー内の横の参照禁止」があるため、循環依存が構造的に起きなくなります。特定の機能が不要になったときは、そのディレクトリをごっそり削除するだけで安全にコードを整理できます。

    FSD導入によりぶつかった課題

    ① features なのかentitiesなのか迷う

    運用初期に最も多かったのが、この2つの境界線の判断です。

    対策:私たちのチームでは、最初は entity にデータ表示用の薄いUIだけを作り、ボタンやAPI通信などのアクションが必要になったら features 側にロジックを切り離す(または外からボタンを流し込む)という方針にしました。

    例えば、「商品画像や金額」は entities に作り、「カート追加ボタンとその処理」は features に作って、上のレイヤー(widgets など)で合体させるイメージです。

    ② ネストが深くなり、ファイル数が増える

    すべての機能に ui, model などのセグメントと index.ts を用意するため、どうしてもファイル数やインポート文の手間が増えます。

    まとめ

    FSDについての紹介と、実際にプロダクトに導入して感じたPros/Consについて書かせていただきました。

    ルールが厳格なので、最初は学習コストがかかりましたが、現状としてメリットを感じる瞬間が多いです。

    また、今後プロダクトをスケールしていくなかで、そのうまみをより感じられることに期待しています。

    参考文献

    FSD公式ドキュメント:https://fsd.how/ja/docs/get-started/overview/

    Feature-Sliced Design – スケーラブルなフロントエンドアーキテクチャを目指して: https://zenn.dev/akfm/articles/feature-sliced-design
  • Kubernetesの概要をやさしく解説

    Kubernetesの概要をやさしく解説

    はじめに

    皆さんは「Kubernetes(クバネティス)」について聞いたことはあるでしょうか。

    近年は Docker を利用したコンテナ開発が一般的になり、多くのシステムでコンテナ技術が採用されています。

    しかし、コンテナ数が増えてくると、

    • コンテナの起動管理
    • 負荷増加時のスケール対応
    • 障害発生時の復旧

    などを手動で管理するのが難しくなります。
    そこで登場するのが Kubernetes です。

    以前のDockerの概要をやさしく解説に関連する記事として、

    • Kubernetesは聞いたことはあるけど触ったことがない
    • Dockerを利用してるけど個数が増え管理を楽にしたいが方法がわからない

    という方に読んでいただければと思います。

    概要

    Kubernetesは、コンテナ化されたアプリケーションのデプロイ、スケーリング、および及び管理を自動化してくれるツールです。
    オープンソースのため、どなたでも利用することができます。

    Docker が「コンテナを実行する技術」だとすると、Kubernetes は「大量のコンテナを管理する技術」と考えるとイメージしやすいでしょう。

    例えば、

    • Webサーバー
    • APIサーバー
    • バッチサーバー

    といった複数のコンテナを運用している場合、Kubernetes がそれらをまとめて管理してくれます。

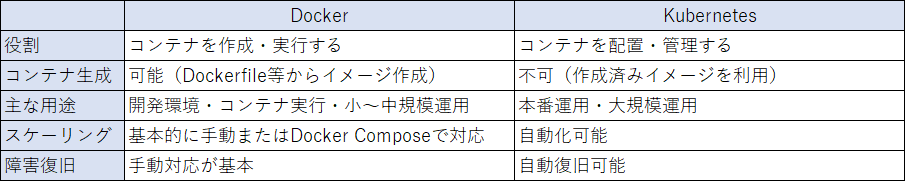
    KubernetesとDockerの違い

    Dockerとの主な違いは下記の通りです。

    DockerとKubernetesは競合関係ではなく、組み合わせて利用されることが一般的です。

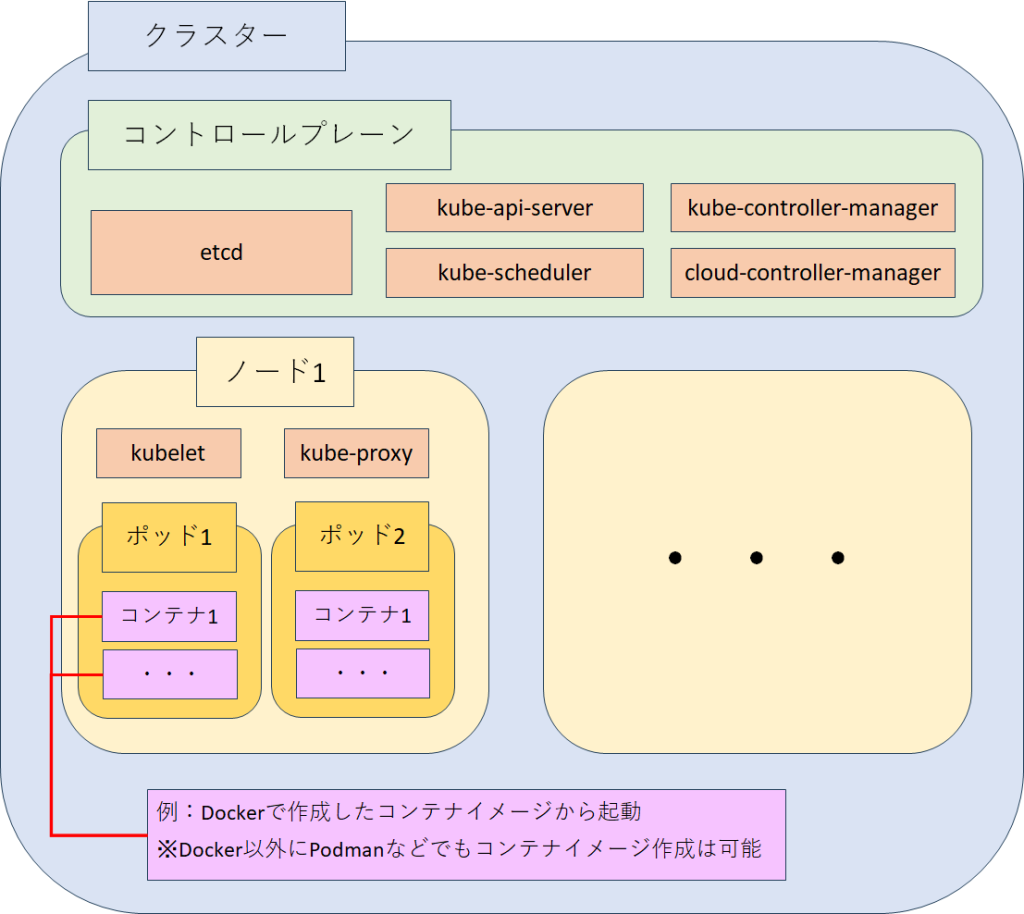
    Kubernetesの構成図

    構成を図にすると下記です。


    Kubernetesでは、コントロールプレーンがクラスター全体を管理し、ノード上でポッドが実行されます。
    ポッドの中では実際のコンテナが動作します。

    構成図で出てきた用語について、把握しておくべき内容を下記に記載しました。

    Kubernetesを使うメリット

    ①自動スケーリングが可能

    アクセス数やCPU使用率の増加に応じて、Pod数を自動で増やし負荷を分散できます。

    逆に負荷が減少した場合はPod数を減らし、リソースを効率的に利用できます。

    例えばECサイトでセール時にアクセスが急増した場合でも、手動でサーバーを追加する手間を削減できます。

    ②自己修復(Self-Healing)機能

    Kubernetesの大きな特徴の一つが自己修復機能です。

    コンテナが異常終了した場合、

    • 自動再起動
    • 別Nodeで再作成

    といった復旧処理を自動で行います。

    障害が起きた場合でも人的コスト削減につながり、可用性向上につながります。

    ③ローリングアップデートが容易

    本番サービスを停止せずに新バージョンへ切り替えることが可能です。

    新しいPodを順次立ち上げながら古いPodを停止することで、ダウンタイムを最小限に抑えられます。

    大規模Webサービスやマイクロサービス構成では特に恩恵を受けやすい機能です。

    ④サービスディスカバリとロードバランシング

    コンテナのIPアドレスは動的に変わることがあります。

    Kubernetesはサービス機能によってポッドの増減に応じて通信先を自動的に管理し、ロードバランシングを実現します。

    Kubernetesを使うデメリット

    ①学習コストが高い

    Dockerと比較すると学習範囲が広くなります。

    構成図で挙げたとおり独自の用語が多いため、Dockerは触ったことがあってもKubernetes特有の要素を把握する必要があります。

    ②運用の複雑さ
    Kubernetesは高機能である一方、管理するコンポーネントが多く、運用が複雑になりやすいというデメリットがあります。

    また、Kubernetesは更新が頻繁にあるため知識を更新し続ける必要があります。

    ③マネージドサービスとの比較検討が必要

    クラウド上で利用する場合、

    • Amazon EKS
    • Azure Kubernetes Service (AKS)
    • Google Kubernetes Engine (GKE)

    などのマネージドサービスも選択肢になります。

    自前でクラスタを構築するのか、マネージドサービスを利用するのかは可用性・運用コスト・管理負荷を考慮して検討する必要があります。

    おわりに

    Kubernetesはコンテナ運用を効率化するためのプラットフォームです。

    小規模なシステムではDockerのみで十分な場合もありますが、大規模運用や高可用性が求められる環境ではKubernetesが有力な選択肢となります。

    参考資料


  • AI倫理について考えよう!

    皆様、AIを使っていますか?
    現在、プログラムの開発をしている方は使わない日はないと思います。
    この記事はAIに疑問を訪ねたり、愚痴のはけ口にする人からプログラム開発をする人まで幅広い層に向けて記事を書きました。
    AIをこれから使う、たまに使うくらいといった方も是非読んでいただけると幸いです。

    AI倫理とは

    AIを利用するときに用いられる倫理観です。

    AIを開発・提供・利用する時に、人や社会へ不当な不利益や被害を与えないようにするための考え方、行動基準と理解していただければと思います。

    AI倫理において意識する5つのポイント

    具体的にAI倫理で重視される以下の5点を紹介させていただきます。

    「公平性」

    AIを利用する際に特定の属性を持つ人に対して差別的判断をしないようにすること
    例:採用選考時に使用するAIには個人の能力ではなく関係のない属性(性別や人種など)で不利益な判断を与えないようにする。

    公平性を確保するためにAI利用によって不利益を受けた人が異議を申し立てられる仕組みを設けることも大切です。

    一般的な利用者側も「AIの回答には偏りがあるかもしれない」といった可能性を前提にすることが重要です。
    異議申し立てを可能にする仕組みを設けるためにも以下の「透明性」が重要になってきます。

    「透明性」

    AIが使われていること、どのような情報をもとに判断をしているかが利用者にもわかる状態にしておくこと
    例:AIによる採用選考時にAIが使用されていること、どのような能力から判断されているかわかるようにする

    AIが利用している情報の説明を求めたときに回答を求めることができることを事前に利用規約やプライバシーポリシーを読んで確認しておきましょう。

    AIを用いた画像、文章を公開する時はAIを用いたことを明記することも透明性に繋がります。

    「プライバシー」

    個人に関する情報を必要以上に集めずに同意や正当な目的がない場合は利用しない
    例:個人の名前や住所などをAIの精度を高めるために利用しないようにする。正当な目的がある場合は同意を得て、必要な期間利用する。

    利用者側も入力する情報を自分で把握、管理しなければいけません。
    例えばAIを利用してメールの文面を作成する時に、名前を仮名に置き換えたりするといった対策もできます。

    「安全性」

    AIによる不正利用や誤作動で被害が発生しない様にする
    意図的に悪用をしない
    例:AIに危険な操作を行わせない
    フェイク画像やフェイク動画で他人を貶める

    AIは想定外の利用方法で利用されることがあります。
    AIを開発・提供する立場の方は想定外の使い方や攻撃を受けた場合も安全に利用できるかを検証、用意する必要があります。

    生成した画像や情報を鵜吞みにして拡散しないといったことも安全性を考える上で重要です。

    「責任の所在」

    AI利用による問題が発生した時に説明、責任を負う人を決めておく
    例:最終的な決定権、責任は人間が持つ

    最終的な責任は利用者にもあるという意識を持ちましょう。

    AI利用による出力に誤りや問題があった場合は訂正や削除を行う責任を持つことが大切です。
    AIは責任を取れません。例としてOpenAI(ChatGPTなどのサービス)の利用規約には
    「当社のサービスから得られたアウトプットの使用はお客様ご自身の責任であり、アウトプットを唯一の真実若しくは事実の情報源として、又は専門家のアドバイスの代替として依拠しないことに、お客様は承諾し同意するものとします。」
    とあります。AI利用時の責任の所在は理解したうえで利用していきましょう。
    https://openai.com/ja-JP/policies/row-terms-of-use/ [1]

    ここまで読むと

    開発、提供をしていなくてもAI利用による被害を受ける可能性があることを理解できると思います。

    AI利用による被害を受けないように開発、提供する方はもちろん、利用者についてもAI倫理を考えていく必要があります。

    実はAI倫理にもガイドラインがあったりします

    AI倫理って何?難しいよ。そんなことを思うかもしれません。

    内閣府からは人間中心のAI社会原則というガイドラインが発信されています。

    https://www8.cao.go.jp/cstp/ai/ningen/ningen.html [2]

    こちらのガイドライン以外にも総務省や経済産業省などからもビジネスサイド向けやAI開発者向けのガイドラインが発信されています。

    AI倫理について難しく考えている方は是非ガイドラインを確認しましょう!

    ガイドラインをベースにAI倫理観を理解してAIを適切に利用できる判断力を身につけられるようにしましょう。

    おわり

    AI倫理についてみんなで考えていこう!と長々書かせていただきました。

    AIは便利な道具ですが、倫理観が伴っていない場合は自分はもちろんのこと、周りに被害を伴う可能性があります。
    幼い子供が危険性を理解せずに包丁を扱うことと同じです。

    すべての人が気持ちよく過ごせる世界にするためにAIの利用方法についてこれからも考えていただけたらと思います。

    便利でよい世の中を目指しましょう!ありがとうございました。

    参考文献・出典

    [1]総務省・経済産業省(2026)『AI事業者ガイドライン』
    (URL 2026年6月29日閲覧)

    [2]OpenAI「利用規約」
    (URL 2026年6月29日閲覧)

    画像はOpenAI社 ChatGPTから画像出力を行いました。

  • AI時代におけるエンジニアの役割

    1. はじめに

    近年、生成AIの発展によりソフトウェア開発の在り方は大きく変化しています。ChatGPTやCopilotをはじめとする生成AIは、コード生成や設計の補助、テストコードの作成、エラー調査など、これまでエンジニアが多くの時間を費やしてきた業務を支援できるようになっています。その結果、開発効率は飛躍的に向上し、「AIがプログラマーに取って代わるのではないか」という議論も珍しいものではなくなりました。

    しかし、日々の開発業務に携わる中で感じるのは、AIが得意とする領域と、人間でなければ担えない領域があるということです。AIは膨大な知識を基にコードを生成できますが、そのコードが本当に業務要件を満たしているのか、既存システムにどのような影響を及ぼすのかといった判断までは行えません。

    本記事では、私自身の開発経験を踏まえながら、生成AIによって変化した開発業務と、それでもなお人間に求められる役割について考察したいと思います。

    2. AIによって変わった開発業務

    生成AIの普及によって、開発者の働き方は大きく変わりました。特に変化したのは、「検索する時間」が大幅に減ったことです。

    以前は、Javaの書き方やVueの文法、SQLの書き方などで疑問が生じるたびに、公式ドキュメントや技術ブログを複数見比べながら情報を収集していました。必要な情報にたどり着くまでに時間がかかり、情報が古かったり、プロジェクトの環境と一致しなかったりすることも少なくありませんでした。

    それが現在では、生成AIに状況を説明することで数秒から数十秒程度で複数の解決案を得られるようになりました。コードの生成だけでなく、「なぜこのエラーが発生するのか」「どのような実装方法が考えられるのか」などの相談も対話形式で行えるため、試行錯誤に費やす時間は大幅に削減されています。

    私自身も、以前はほとんどAIを活用していませんでしたが、現在では実装方法の検討やエラー原因の調査など、日常的な開発業務において生成AIを利用しています。

    生成AIは単なる検索ツールではなく、知識を整理し、最初の案を提示してくれる開発パートナーになりつつあります。

    3. AIでは解決できなかったこと

    一方で、生成AIを活用する中で「AIだけでは解決できない問題」が多く存在することも実感しました。

    私自身、CSSのレイアウト修正などで生成AIを活用することがあります。しかし、AIが提示した修正方法をそのまま適用しても問題が解決しないケースは少なくありませんでした。実際には複数のCSSが相互に影響し合っていたり、VueとThymeleafの組み合わせによって描画タイミングが変化していたり、既存の共通CSSとの兼ね合いが原因だったりと、プロジェクト固有の事情が影響していることが多かったためです。

    AIはCSSを書いてくれます。しかし、「なぜレイアウトが崩れているのか」を分析するには、画面構成や既存の設計思想、業務仕様、さらにはプロジェクト全体の実装方針まで理解している必要があります。これは、現時点ではAIだけで判断できる領域ではありません。

    また、開発現場で本当に時間がかかるのは、コードを書くことそのものではありません。「なぜそのコードが必要なのか」「なぜ不具合が発生しているのか」「この修正は他画面へ影響しないか」といった背景を分析することに、多くの時間が費やされます。

    生成AIは優れたコードを提示できます。しかし、そのコードが適切かどうかを判断するには、システム全体を理解し、業務要件との整合性を確認する人間の存在が不可欠です。この経験を通じて、AIは開発者を代替する存在ではなく、開発者の思考をサポートする存在なのだと考えるようになりました。

    4. AI時代だからこそ求められる能力

    生成AIの登場によって、「コードを書く能力」の重要性が無くなったわけではありません。しかし、それ以上に価値が高まっている能力があります。

    それは、問題を分析する力、仕様を理解する力、設計する力、そしてレビューする力です。

    AIはもっともらしい回答を返します。コードも自然に生成し、一見すると正しく動作するように見えることも少なくありません。しかし、「この実装は業務仕様として本当に正しいのか」「セキュリティ上問題はないのか」「既存機能へ悪影響はないのか」といった判断は、人間の経験や知識、そしてシステム全体への理解があって初めて可能になります。

    つまり、AIがコードを書けるようになったからこそ、人間には「コードを書く人」ではなく「コードを評価し、最終判断を下す人」としての役割がより強く求められるようになったと言えます。

    また、AIを活用する上で重要なのは「AIの回答を疑う力」だと考えます。AIが提示した内容を鵜呑みにするのではなく、その根拠を確認し、自ら検証する姿勢が欠かせません。

    AIは非常に優秀なツールですが、責任を負うことはありません。責任を負うのは、最終的にそのコードを採用し、システムとして提供するエンジニアです。この点はAIがどれほど進化しても変わらない本質だと考えています。

    5. 最後に

    生成AIは、エンジニアの仕事を奪う存在ではなく、エンジニアの能力を拡張する存在だと言えます。コード生成や情報収集といった作業は今後ますますAIが担うようになるかと思いますが、課題の本質を見極め、最終的な判断を下す役割は、依然として人間にあります。

    私自身、生成AIを活用する機会は増えましたが、「本当にこの回答は正しいのか」「自分は何を理解していて、何を理解していないのか」を意識する機会が増えました。

    古代ギリシャの哲学者ソクラテスの言葉に、「無知の知」という考え方があります。これは自分が知らないことを自覚することこそが、真の知識への第一歩であるというものです。生成AIが高度な回答を提示する時代だからこそ、この考え方はこれまで以上に重要になると考えます。

    AIの回答をそのまま受け入れるのではなく、自ら考え、検証し、必要に応じて修正する。そして、自分が理解できていない部分を認識し続ける姿勢を持つことが、これからのエンジニアに求められる資質であると考えます。AIを使いこなす技術だけではなく、「無知の知」の姿勢を忘れずに学び続けることこそが、この時代において最も重要な力なのではないでしょうか。

  • OpenSearchクエリについて知ろう

    OpenSearchクエリについて知ろう

    こんにちは、今回は今私が勉強している OpenSearch クエリ について、これから OpenSearch を触れる方に向け、扱い方や考え方を、私自身の経験を踏まえて解説していきたいと思います。

    ※本来 OpenSearch には「フィールドのデータ型」という重要な概念があり、クエリの挙動にも関わってきます。
    しかし、本記事は初心者向けということを重視し、最初の一歩としては複雑な内容になるため、今回はあえて触れていません。

    まずはクエリの“書き方”と“考え方”を身につけましょう!

    ◆そもそも OpenSearchって何?

    OpenSearch は、一言でいうと

    「大量のデータを高速に検索・分析するためのオープンソースの検索エンジン」

    です。

    検索対象のデータは index(インデックス)と呼ばれる領域に保存されます。
    indexとは SQL でいう テーブル のようなもので、データをJSON形式で構造化して保持する場所です。
    indexにデータを入れておくことで、OpenSearch はその中から

    ・特定のキーワードを含む文章を探す(match)

    ・数値や日付の範囲で絞り込む(range)

    ・完全一致するデータだけを取得する(term)

    といった検索を、非常に高速に行うことができます。

    そして、私が OpenSearch クエリの一番の特徴だと思っているのが、

    検索条件を JSON 形式で書く

    という点です。

    検索条件そのものを JSON の構造で表現するのが OpenSearch のクエリ DSL(Domain Specific Language)です。

    私自身、最初はJSON の構造に苦戦しました。「なんでこんなにネストが深いの?」と感じながら、構文エラーを連発していましたが、慣れてくると

    ・直感的にフィールドに対して条件を指定できる。
    ・ネストによって、条件の組み合わせを自在に変更できる。

    というメリットに気づき、簡単なクエリであればサクッと記述できるようになりました。

    さらにOpenSearchクエリに慣れることができれば

    ・JSON オブジェクトの構造に強くなれる。

    という副産物のメリットもあります。

    OpenSearchクエリは、JSONにさえ慣れてしまえば、

    SQL の WHERE 句に近い考え方を、
    JSON 形式で表現しているもの

    と考えるだけで一気に理解しやすくなると思います。

    SQL ではこのように書く部分を

    SELECT * FROM users WHERE status = 'active'

    OpenSearchでは以下のように書くことができます。

    {
     "query": {
      "term": {
       "status": "active"
      }
     }
    }

    ◆ 実際に index を作って考えよう。

    OpenSearch のクエリを理解するうえで、
    「どんなデータが入っているのか」 をイメージできることはとても大事なことです。

    なのでここでは、実際に次のような 書籍データを扱う index を例にして、そこからデータを取得するという前提で話を進めていきます。

    例:books という index に次のようなデータが入っている

    {
     "title": "すぐわかる お料理入門",
     "category": "cooking",
     "price": 1200,
     "published_at": "2024-01-10"
    },
    {
     "title": "月刊わくわくコミック",
     "category": "comic",
     "price": 800,
     "published_at": "2024-02-01"
    },
    {
     "title": "お料理戦隊 炊飯ジャー",
     "category": "comic",
     "price": 600,
     "published_at": "2024-03-05"
    }

    “{“から”}“までが一つのデータのまとまりになります。

    つまり、この場合は3冊分の書籍データがindexに登録されているということです。

    それぞれの書籍データには

    title : タイトル
    category : 書籍の種類
    price : 価格
    published_at : 出版日

    の4つのフィールドが紐づけられています。

    ◆ クエリを書いてみよう

    ここからは、先ほどの books index に対して
    「どんな検索ができるのか」 を具体的に見ていきます。

    ① タイトルに「お料理」を含む本を探す(match)

    GET books/_search
    {
     "query": {
      "match": {
       "title": "お料理"
      }
     }
    }

    match は 全文検索です。

    今回は”title”フィールドに対して”お料理”という文字列を当てて検索しています。

    条件にした文字列が、indexの文字列に部分一致してればヒットします。

    ですので今回の場合にヒットするのは:

    ・すぐわかる “お料理”入門

    ・”お料理”戦隊 炊飯ジャー

    の2冊になるというわけです。

    ② category が “comic” の本だけを取得する(term)

    GET books/_search
    {
     "query": {
      "term": {
       "category": "comic"
      }
     }
    }

    termは完全一致検索です。
    categoryが”comic”のものだけを取得します。
    “comic_A”など”comic”を文字列として含んでいても取得することはできません。

    ですのでこの場合にヒットするのは

    ・月刊わくわくコミック

    ・お料理戦隊 炊飯ジャー

    の2冊になるというわけです。

    ③ price が 1000 円以上の本を取得する(range)

    GET books/_search
    {
     "query": {
      "range": {
       "price": {
        "gte": 1000
       }
      }
     }
    }

    数値・日付は range で検索することが基本です。

    rangeは数値や日付を範囲で検索することができます。

    “gte” : 1000の “gte” は

    Greater Than or Equalつまりその値以上という意味なので、

    今回の場合、ヒットするのは:

    ・すぐわかる お料理入門(1200円)

    だけになります。

    “その値以下”の検索をする場合は”lte”

    Less Than or Equalを使用します。

    gteとlteを組み合わせることで特定の範囲に絞って検索をすることも可能です。

    ④ 条件を組み合わせる(bool)

    ここまでで、単体の検索(match / term / range)について見てきました。

    ですが実際の検索では、

    「タイトルに“お料理”を含む」

    だけでなく、

    「タイトルに“お料理”を含み、かつ category が cooking のもの」

    のように、複数の条件を同時に満たすデータを探したい場面がほとんどです。

    このように条件を組み合わせるときに使うのが、次の bool クエリです。

    例えば、先ほどの

    「タイトルに“お料理”を含み、かつ category が cooking の本」

    を探したい場合はこうなります。

    GET books/_search
    {
     "query": {
      "bool": {
       "must": {
        "match": { "title": "お料理" }
       },
       "filter": {
        "term": { "category": "cooking" }
       }
      }
     }
    }

    bool クエリでは、役割ごとに条件を書き分けます。

    must は「検索条件」です。
    今回でいうと「タイトルに“お料理”を含む」の部分です。

    filter は「絞り込み条件」です。
    「category が cooking のものだけ」のように、
    単純に条件で絞りたいときに使います。

    つまり、

    must → 見つけたい内容
    filter → 絞り込むための条件

    というイメージです。

    このあたりは、一段レベルアップした内容になるため
    また次回、詳しく解説させていただきます。

    ◆ まとめ

    いかがでしたでしょうか。
    OpenSearch のクエリは最初こそ独特に見えますが、
    実際には 「SQL の WHERE 句に近い考え方を、JSON 形式で表現しているもの」 と考えると、ぐっと理解しやすくなります

    特に match / term / range の3つと、
    それらを組み合わせる bool クエリ を押さえておけば、
    実践的なクエリを理解するための大きな足掛かりになります。

    この記事がこれから OpenSearch を触る方の助けになれば嬉しいです。

  • 心地よいWebサイトについて考える

    心地よいWebサイトについて考える

    ― 色・余白・動きの観点から

    私たちは日常的に多くのWebサイトを利用しています。
    企業のホームページやECサイト、ニュースサイトなど、さまざまなサイトを見る中で、
    「なんとなく見やすい」「使いやすい」と感じるサイトがある一方、「おしゃれだけど少し使いにくい」と感じるサイトに出会うこともあります。

    こうした違いは、単にデザインの好みだけで生まれるものではありません。
    Webデザインには、見た目を整えるだけでなく、ユーザーが快適に情報を得られるようにする役割があります。

    今回は、ユーザーが快適使いやすいWebサイトを支える要素として、「色」「余白」「動き」の3つの観点から考えてみたいと思います。


    色が与える印象 

    Webサイトを開いたとき、私たちは無意識のうちに全体の雰囲気や印象を受け取っています。その中でも大きな役割を果たしているのが色です。

    サイト全体で色使いに統一感があると、情報が整理されているように感じられ、安心感にもつながります。
    ただ、同系色だけでまとめてしまうと印象がぼやけてしまい、うまくユーザーに情報が届けられないこともあると私は思います。

    そのため、ベースカラーだけでなくアクセントカラーを効果的に使用することで、ユーザーの視線を集めたい場所を自然に目立たせ、より印象付けることも必要です。

    例えば、お問い合わせボタンや申し込みボタンなど、
    ユーザーに注目してほしい箇所にアクセントカラーを使用することで、自然と視線を誘導することができます。

    こうした工夫は、ユーザーが迷わず目的の操作を行うためにも重要です。

    企業サイトにおいては、色はブランドイメージにも関わる重要な要素です。
    信頼感や親しみやすさ、高級感など、伝えたい印象に合わせて色を選ぶことで、企業やサービスへのイメージ形成にもつながります。


    □ □ 余白は「何もない場所」ではない 

    Webデザインにおいて、余白は単なる空きスペースではありません。

    情報を整理し、読みやすさを向上させるための重要な要素です。

    文字や画像を詰め込みすぎると、ユーザーはどこから読めばよいか分からなくなり、情報を探すこと自体が負担になってしまいます。
    一方で適切な余白があると、情報のまとまりが分かりやすくなり、見出しや重要な内容も自然と目に入りやすくなります。

    ただし、余白を増やせば良いというものでもありません。
    情報の区切りを余白だけに頼りすぎると、かえって情報のまとまりが分かりにくくなってしまうこともあります。

    読みやすさを実現するためには、余白とレイアウトのバランスが重要です。

    私自身、見出しと本文の間隔や情報同士のまとまりが整理されているサイトは、内容がすっと頭に入ってくるように感じるため、
    このブログにおいても見出しのサイズや行間に気をつけて作成しています。


    心地よさを左右する動きと表示速度 

    近年のWebサイトでは、スクロールに合わせて要素が動いたり、アニメーションが表示されたりする演出を見かけます。
    今やアニメーションを使っていないサイトのほうが少ないような気もしています。

    こうした動きはサイトに楽しさや、現代的で先進的な印象を与える効果があります。

    特に企業サイトでは、アニメーションを活用することで製品やサービスの魅力を印象的に伝えられる場合もあります。
    適切に使われた動きはユーザーの理解を助け、サイト全体の体験価値を高めることにつながります。

    しかし、演出が多すぎると、かえって情報収集の妨げになることもあります。

    私はよく、アニメーションが多すぎて情報にたどり着くまでに時間がかかってしまうと、ブラウザバックしてしまいます。

    また、画像を多く使用しすぎることでページの表示速度が遅くなったり、画面遷移に時間がかかったりするのも、
    私のようにユーザーの離脱につながる可能があります。

    ゲームや飲食店のWebサイトでは、魅力を伝えるために多くの画像が使用されることがあります。
    しかし、画像量が増えすぎると表示速度に影響し、ユーザー体験を損なう要因にもなります。

    どれだけ見た目が魅力的でも、目的の情報にたどり着けなければ、使いやすいWebサイトとは言えません。
    デザインと同じくらい、情報の整理や導線設計も重要な要素なのです。


    まとめ

    このブログを書くにあたり、普段何気なく見ているWebサイトを改めて観察してみました。

    すると、以前は「動いていてすごい」程度に感じていた演出が、
    今は情報を探す際の妨げに感じることもあり、見方を変えてみるとなにかと気付きがありました。

    Webデザインというと色やレイアウトなどの見た目に注目しがちです。
    しかし実際には、ユーザーが迷わず情報を見つけられるか、ストレスなく閲覧できるかといった体験に大きく関わっています。

    色は印象をつくり、余白は情報を整理し、動きは快適な閲覧体験を支えます。

    使いやすく心地よいWebサイトは、こうした要素がバランスよく組み合われることで生まれています。
    普段何気なく利用しているWebサイトも、少し視点を変えて見てみてはいかがでしょうか。

    新しい発見があるかもしれません。

  • Claude Mythos(クロード・ミュトス)今後の開発現場への影響

    Claude Mythos(クロード・ミュトス)今後の開発現場への影響

    はじめに

     近年、生成AIは文章作成や要約、プログラミング補助の道具として急速に普及してきました。
    開発現場でも、コードレビュー、テストケース作成、設計書のたたき台作成など、日常業務の一部にAIを取り入れる動きは珍しくなくなっています。
    その流れの中で注目を集めているのが、Anthropic(アンソロピック)が発表した最新AIモデル「Claude Mythos Preview」です。
    以下では、「Claude Mythos」と表記します。
    Anthropicは2026年4月7日、Claude Mythosを活用して重要ソフトウェアを守る取り組み「Project Glasswing」を発表しました。

     Project Glasswingは、世界中の重要なソフトウェアをAI時代に向けて安全にするための取り組みであり、AWS、Apple、Broadcom、Cisco、CrowdStrike、Google、JPMorgan Chase、Linux Foundation、Microsoft、NVIDIA、Palo Alto Networksなどがローンチパートナーとして参加しています。
    さらに、重要ソフトウェア基盤を構築・保守する40以上の組織にもアクセスを拡大しています。
     ここで押さえておきたいのは、Claude Mythosが、一般ユーザー向けの便利なコーディングAIとして広く提供されたものではなく、Project Glasswingを通じて防御目的で限定的に提供されている点です。
    公式発表では、Claude Mythosについて「一般提供する予定はない」としつつ、将来的にはMythos級のモデルを安全に展開できるよう、危険な出力を検知・遮断する安全対策の開発が必要だとしています。

    Claude Mythosが注目されている理由

     Claude Mythosが注目される理由は、サイバーセキュリティ領域での能力にあります。
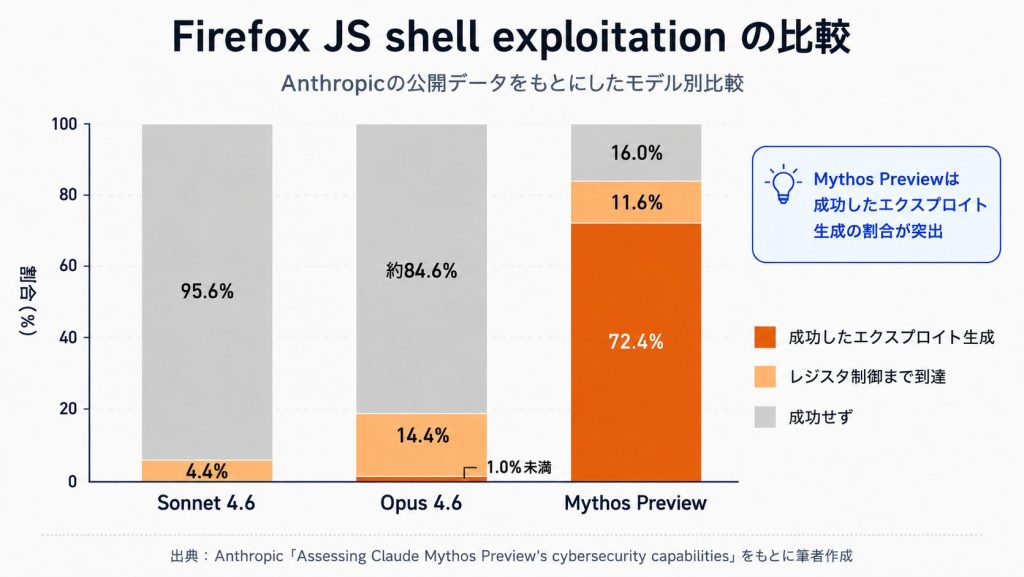
     Anthropicの技術ブログでは、Claude Mythosについて、一般目的の言語モデルでありながら、コンピューターセキュリティの分野で際立った能力を示したと説明しています。
    特に、まだ知られていない脆弱性の発見や、脆弱性を悪用可能かどうかの検証において大きな能力を示したとされています。
    さらに「セキュリティー訓練を受けていないエンジニアが使っても、一晩のうちに弱点を見つけ出して翌朝には攻撃手段が完成していた」と発表されており、少ない専門知識でも高度な脆弱性発見・悪用に到達し得ることが、特に注目されています。
    日本でも、金融庁・日銀・メガバンクなどが、Claude Mythosを含む高度AIによる金融システムへのリスクについて意見交換を行うと報じられています。

     これまでの生成AIは、多くの場合「高性能なモデルを公開し、ユーザーが活用する」という流れで広がってきました。
    しかしClaude Mythosでは、性能が高いからこそ悪用リスクも大きいと見られており、その観点から公開範囲を制限する判断がされています。

    開発現場への影響

     AnthropicはProject Glasswingの目的として、重要なシステムを守る防御側に先行してAI能力を提供することを挙げています。
    Project Glasswingのパートナーは、Claude Mythosを使って、自社や重要インフラの脆弱性を発見し、修正することができます。
    この方針は、開発現場にとっても大きな意味を持ちます。
    AIは単に開発を速くする道具ではなく、開発したものの弱点を人間よりも速く見つける道具にもなりつつあります。
     Claude Mythosの登場によって、開発現場で変わるべきなのは「AIを使って開発速度を上げるかどうか」だけではありません。
    重要なのは、開発工程そのものにAIを使用したセキュリティ対策を組み込む必要性が一段上がったという点です。
    すべての現場がそうではないですが、セキュリティ確認が後工程になってしまうケースは少なくないと考えられます。
    各開発現場では今後、Claude Mythosのような高度なAIが一般的に利用可能となることを見据え、脆弱性の早期発見および迅速な対応ができる体制をあらかじめ整備しておくことが重要です。

    今後の展望

     大和総研のコラムでは、Claude Mythosの性能が従来モデルより高いと評価する一方で、他のモデルも短期間で追随してくるため、企業が備えるべきなのはClaude Mythos単体ではなく、AI時代そのものだと整理しています。
    この指摘は開発現場にも当てはまります。
    重要なのは「Claude Mythosのような特定のAIを特別視すること」ではなく、今後発表されるあらゆるAIによって脆弱性の発見、攻撃コードの作成、修正案の提示、検証作業の自動化が進む可能性があるということです。
    その前提で、開発・運用プロセスを見直すことが必要であると考えられます。
     また、Trend Microの記事では、Claude Mythosは従来の自動脆弱性スキャナとは異なり、マルチステップなサイバーセキュリティタスクで能力を示すモデルだと整理されています。
    そのうえで、本当のボトルネックは「発見」ではなく「修復」であると指摘しています。
    脆弱性が見つかっても、すぐに直せるとは限りません。
    影響範囲の調査、影響確認、テスト、リリースなど、多くの工程が必要になります。
    AIが脆弱性を大量に見つけられるようになれば、現場の負荷は単純に減るのではなく、むしろ何を先に対処するかの見極めと、すぐ動ける対応体制の重要性が、これまで以上に高まると考えられます。

    最後に

     Claude Mythosは、あまりに強力なサイバーセキュリティ能力を持つため、一般公開されることなく、防御用途のProject Glasswingを通じて限定的に活用されているAIです。
    この事実は、開発現場にとっても決して他人事ではありません。
    今後は、AIによって実装を効率化するだけでなく、AIの存在を前提にしたセキュリティ設計や、脆弱性の検知から修復、運用までを迅速に回せる体制づくりが、これまで以上に重要になります。
    この記事で伝えたかったのは、Claude Mythosが単なる「高性能AIの登場」ではなく、開発現場に対して従来のセキュリティ対策の考え方を見直し、AI時代に適した開発体制へ移行する必要性を示している、という点です。


    参考文献

  • Raspberry Pi初心者がSSH接続環境を構築するまでの記録

     今回は、前回のリモートデスクトップ接続に続き、
     Raspberry Pi を SSH で操作できる環境構築に挑戦した内容をまとめます。

     SSH 接続ができるようになると、
     モニター・キーボードを別で用意しなくても
     Raspberry Pi を操作できるようになり、
     より “IoT デバイスらしい使い方” ができるようになります。

     これから Raspberry Pi を触ってみたい方の参考になれば嬉しいです。

    ◆SSHとは?

     SSH(Secure Shell)は、
     ネットワーク越しに別のコンピュータへ安全に接続し、
     コマンド操作を行うための仕組みです。

     Raspberry Pi では標準で SSH が利用でき、
     Windows や Mac からリモートで操作する際の定番手段となっています。

    ◆SSH接続を行うメリット

     モニター・キーボード不要で操作できる

     軽量で高速(RDPより負荷が少ない)

     サーバー用途・IoT用途で必須の操作方法

     自動化やスクリプト実行と相性が良い

     前回の RDP 接続と比べると、
     GUI ではなく CUI 操作が中心になりますが、
     その分だけ軽くて扱いやすいのが特徴です。

    ◆SSH接続環境の構築手順

     ここからは、実際に私が行った手順をまとめていきます。

    ◆1. Raspberry Pi 側の設定

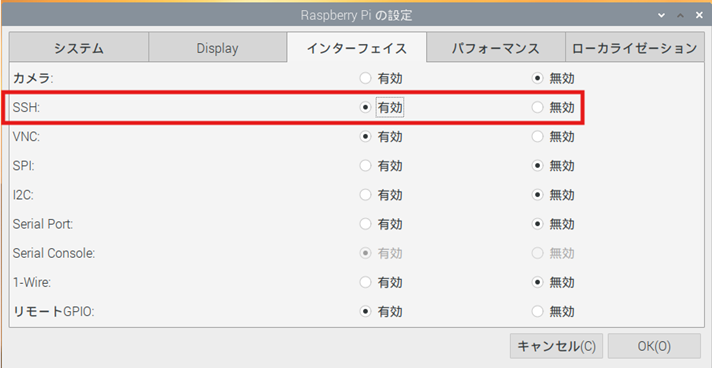
     ① SSH を有効化する

       Raspberry Pi OS では、セキュリティの観点から
       初期状態では SSH が無効になっています。
       有効化する方法は2つあります。
       ※今回はGUIでの有効化を行いました。

    【方法A】GUI から有効化(モニター接続時)

    1. 画面左上の Raspberry メニューを開く
    2. 「設定」→「Raspberry Pi の設定」を選択
    3. 「インターフェイス」タブを開く
    4. 「SSH」を「有効」に変更
    5. 「OK」を押して再起動

    【方法B】CUI から有効化(ターミナル操作)

    sudo raspi-config
     → 「Interface Options」
     → 「SSH」
     → 「Enable」
     →  再起動

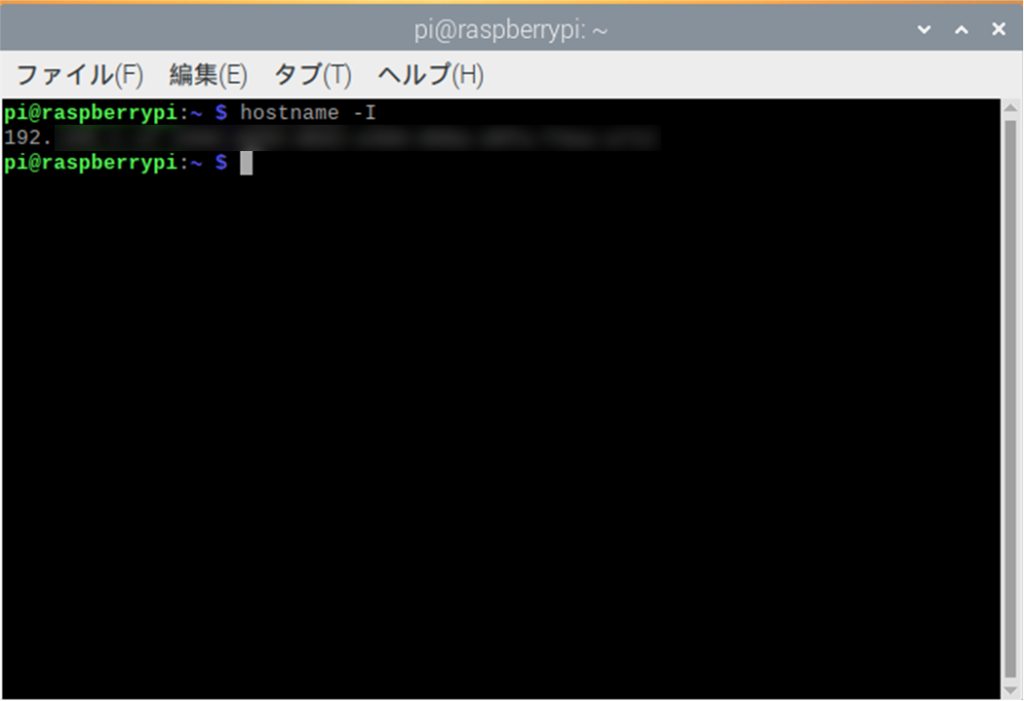
     ② Raspberry Pi の IP アドレスを確認する

       SSH 接続には IP アドレスが必要です。
       こちらも2通りありますが、
       RDPだとGUI時の画面とは異なるようだったので、CUIで確認しました。

        GUI の場合:
         右上のネットワークアイコン → 接続情報

        CUI の場合:

    hostname -I

    ◆2. Windows 側の準備

     Windows 10 以降では、標準で SSH クライアントが搭載されています。

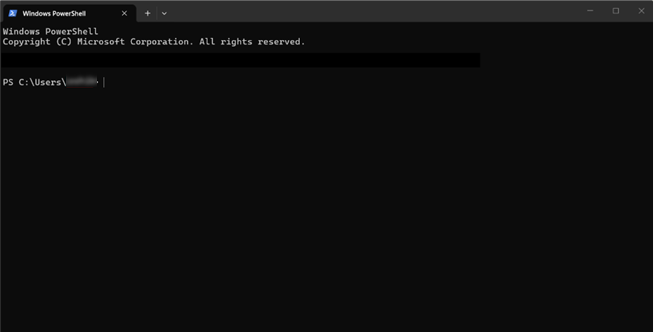
     ① PowerShell を起動

       スタートメニュー →「PowerShell」と入力して起動。

     ② SSH コマンドで接続

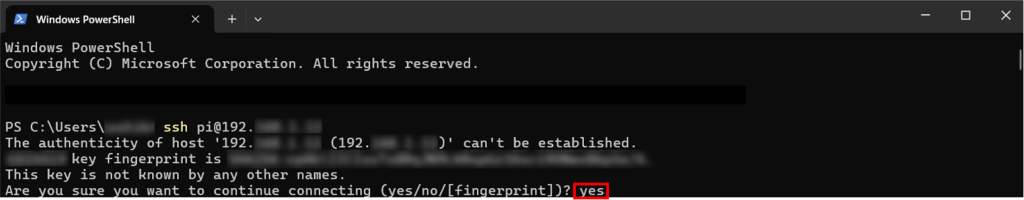
       初回のみ「接続してよいか?」と聞かれるので「yes」。
       続いてパスワードを入力します。
       デフォルトユーザー:
        ユーザー名:pi
        パスワード:OS インストール時に設定したもの

     ③ 接続成功すると…

    上記のようなプロンプトが表示されれば成功です。

    ◆3. SSH接続ができない場合のチェックポイント

     実際に構築してみて、つまずきやすいポイントもまとめておきます。

     ① 同じネットワークに接続されているか?

       Raspberry Pi と Windows が
       同じ Wi-Fi / LAN に接続されている必要があります。

     ② ファイアウォールの設定

       企業ネットワークなどでは SSH(ポート22)が
       制限されている場合があります。
       家庭内 LAN なら基本問題ありません。

     ③ ユーザー名・パスワードの間違い

       特にパスワードは入力しても画面に表示されないため、
       タイプミスに気づきにくいです。

    ◆4. SSH接続後に行ったこと

     SSH 接続ができるようになると、
     Raspberry Pi を “本当のサーバー” のように扱えるようになります。
     私が実際に行った操作は以下の通り。

     ① パッケージ更新

       以下は最新パッケージを取得し、
       最新バージョンに更新するためのコマンドです。

    sudo apt update
    sudo apt upgrade -y

     ② 必要なツールのインストール

       今後を見据えて「git」、「vim」、「htop」をインストールしました。

    sudo apt install git vim htop -y

     ③ 再起動

       RDPからのシャットダウンや再起動は
       うまくいかないことがあったのですが、
       SSHだと確実でした。

    sudo reboot

    ◆5. 今後の展望

     SSH 接続ができるようになったことで、
     次のステップとして以下の開発を進める予定です。

    • Web サーバ構築(Nginx / Apache)
    • Python でのセンサー制御
    • 外出先からの遠隔操作(VPN 連携)
    • スマートホーム化の実験

    ◆まとめ

     今回で最終目標のIoT開発において
     “最低限の基盤”と言えるSSH接続を学ぶことができました。

     また、SSH 接続構築でRaspberry Pi をより深く理解できたと感じています。
      SSH は軽量で高速
      GUI なしで操作できるため IoT 向き
      ネットワークの理解が深まる
      サーバー構築の第一歩として最適
     前回の RDP 接続と合わせて、 用途に応じて使い分けられるようになりました。
     次回は、いよいよ Web サーバ構築 に挑戦する予定です。
     引き続き、学んだことをブログで発信していきます。

  • 形骸化しがちなスクラムについて考える

    毎日朝会をやって、2週間ごとに振り返りをして、ベロシティも安定している。一見するとチームのスクラムがうまく回っているように見えますが、形式通りにイベントをこなしているだけで、実は中身があまり伴っておらずスクラムイベントが正しく機能していないと感じることがこれまでの開発で何度かありました。

    気がつくと、メンバーの意識がプロダクトの価値を届けることではなく、目の前のタスクをスケジュール通りに終わらせることに向いてしまっている。こうした手段の目的化は、どこの現場でも起きがちな悩みなのではないでしょうか。

    今回は、形骸化しがちなスクラムについて、なぜそれが起きるのか、どうやって現場から変えていけばいいのかを、アジャイルソフトウェア開発宣言の思想に立ち返って考えてみたいと思います。

    スクラムが形式的になっている例

    まずは、形骸化しているスクラムのよくある状況を思い浮かべてみます。

    1. デイリースクラムが単なる進捗報告会になっている

    朝会での発言が「昨日これをやりました、今日もこれの続きをやります」という人単位の報告だけで終わっているパターンです。他人が何をしているかに関心が薄れ、自分の担当分を伝えることだけに意識が向いてしまうと、ゴールに向けたチームの対話は生まれにくくなるように思います。

    2. レトロスペクティブが感想戦や精神論で終わっている

    レトロスペクティブで「今スプリントは忙しかったです」という感想で終わったり、「次はもっと意識を高めます」「レビューを早くします」といった、具体的な行動に落とし込めない曖昧な目標ばかりが出ている状態です。これだと、次のスプリントでも実際の動きを変えるのは難しくなってしまいます。

    3. プランニングがタスクの分解作業に偏っている

    POから渡されたバックログを、仕様の背景や「なぜ作るのか」を深くすり合わせないまま、機械的にタスクへ切り分けるだけの時間になってしまうことがあります。この状態だと実装に入ってから認識ズレが起きやすく、あとから手戻りが発生して結果的に工数が膨らむ原因となりかねません。

    なぜ手段の目的化が起きるのか

    スクラムがただのルーティンになってしまうのは、日々の開発に追われていると、決められた型をそのままなぞるのが一番エネルギーを使わずに済むからだと思います。

    毎日忙しくコードを書いてタスクを消化している中で、さらに自分たちの進め方まで見直して変えていくのは、いくらかパワーが必要です。そうなると、とりあえず時間通りに集まって、決まったフォーマットを埋めるだけで手一杯になってしまうのも無理はありません。

    ただ、アジャイルの思想にある「プロセスよりも個人と対話を」という言葉に立ち返ると、イベントを予定通りに終わらせること自体はゴールではないはずです。

    日々の忙しさに流されて、開発を効率的に進めるための手段だったはずのスクラムが、いつの間にか「こなさなければいけない会議」にすり替わってしまう。これが、形骸化が起きてしまう実際のところなのだと思います。

    イベントを形だけにしないための具体的なアクション

    形だけのスクラムを変えるために必要なのは、定例の進め方を綺麗にすることではありません。日々の開発でやりづらく感じていることを、チームで共有し、そのチームで効果的な形に変えていくことだと考えています。チームでこれまでに実践し、良い効果があった具体的な対策をいくつか挙げます。

    1. 朝会を自分のタスクではなく全体のボールを見る場にする

    朝会を、昨日何をしたかを順番に読み上げるだけの場にするのを一回やめてみます。 

    自分の担当分を伝えることも重要ですが、スプリントゴールを達成するためにチームとしてどう動いていくべきかを考えることに時間を割いてみてください。

    個人の進捗ではなくチーム全体の詰まりを解消することに朝会を使う方が、結果的に全員の開発が進めやすくなると考えています。

    2. プランニングでタスクの完了条件をすり合わせる

    渡されたチケットを機械的にタスクへ切り分けるだけの作業は、手戻りの原因にもなります。

    実装を始める前に、どういう状態になれば完了と言えるのかという仕様のゴール、受け入れ条件を、POやチームと一緒にその場で書き出してしまう。

    プランニングの時間は膨らむかと思いますが、仕様の背景や作らなくていい範囲がプランニングの時点でクリアになっていれば、実装中に迷って手が止まることも、レビュー時の認識ズレによる手戻りも、結果的に減らせるはずです。

    3. レトロスペクティブでは、次のスプリントで試す小さな1アクションだけを決める

    「次はもっと意識を高く持って、レビューを早くします」のような、中身のない精神論の目標を立てても何も変わりません。

    次に試すのは、やったか・やらなかったかが客観的に評価できる、小さな行動ルール1つだけで十分です。例えば、「PRのサイズを最大でも200行以内に収まるようにタスクを細かく分ける」といったレベルで構いません。

    実践しやすく、その成果を評価しやすいTRYを立てることで効果的なレトロスペクティブになっていくと考えます。

    型をチームに合わせる

    アジャイル宣言の原則には、「チームが定期的に、どうすればもっと効果的になれるかを振り返り、それに基づいて行動を調整する」と書かれています。

    もし、今のチームに現状のスクラムが合っていないと感じるのであれば、イベントの時間や進め方自体を自分たちに合わせて変えてしまっていいはずです。ルールにチームをハメ込むのではなく、チームに合わせて型を調整していく。イベントをこなすためのスクラムではなく、チームが強くなるためにイベントを使う。そうすることでスクラムの強さを発揮できるようになると考えています。

    スクラムの形骸化を避けるために、改めて今のスクラムイベントがチームに価値を生み出せているかを見直してみようと思います。

    参考文献

    「アジャイルソフトウェア開発宣言」https://agilemanifesto.org/iso/ja/manifesto.html

  • AWS SAPに合格する勉強法|現役エンジニアが実体験から解説

    AWS SAPに合格する勉強法|現役エンジニアが実体験から解説

    はじめに

    AWS認定ソリューションアーキテクト プロフェッショナル(以下、AWS SAP)は、AWS資格の中でも難易度が高い資格の一つです。

    • 何から手を付ければいいのかわからない
    • 模試を解いても点数が伸びない

    そんな悩みを持つ方も多いのではないでしょうか。

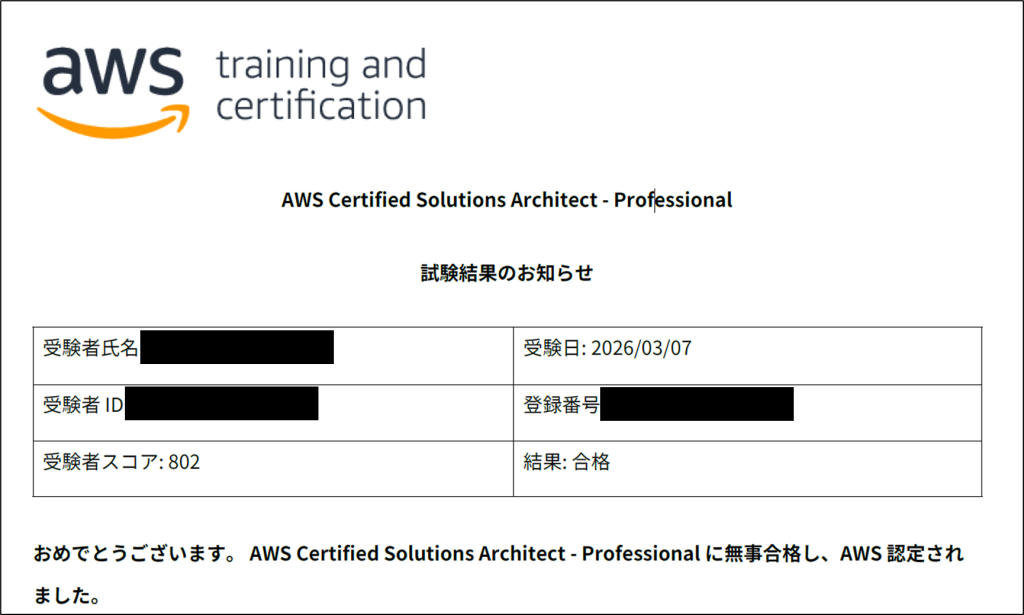
    本記事では実際にAWS SAPに合格した経験をもとに、合格するための勉強戦略と具体的な対策を解説します。

    AWS SAPは難関資格ですが、対策すれば十分に合格可能です。

    本記事では、以下のような方に向けて実体験ベースで解説します。

    想定読者

    • AWS SAPに挑戦したい方
    • AWS SAA(アソシエイト)を取得したものの、AWS SAPの難しさに壁を感じている方
    • 模試の点数が伸びず、勉強方法に不安を感じている方

    筆者のAWS経験・保有資格

    【保有資格】
    ・AWS Certified Security – Specialty(以下、AWS SCS)※2025年3月取得
    ・AWS Certified Machine Learning – Specialty(以下、AWS MLS)※2025年9月取得
    →AWSの中でも難易度が高く設計力が問われるスペシャリティ系の資格を複数保有

    【AWS経験】
    ・2021年12月からAWSの利用を開始
    ・各種サービスに触れながら学習・理解を深めてきた

    試験概要

    AWS SAPは「幅広いサービスの要件に応じた最適なアーキテクチャ設計力」が求められます。

    実際の出題では以下のような特徴があります。

    • 複数サービスを組み合わせた設計問題が中心
    • 正解が1つではなく「最適解」を選ぶ必要がある
    • 長文シナリオ問題で読解力も求められる

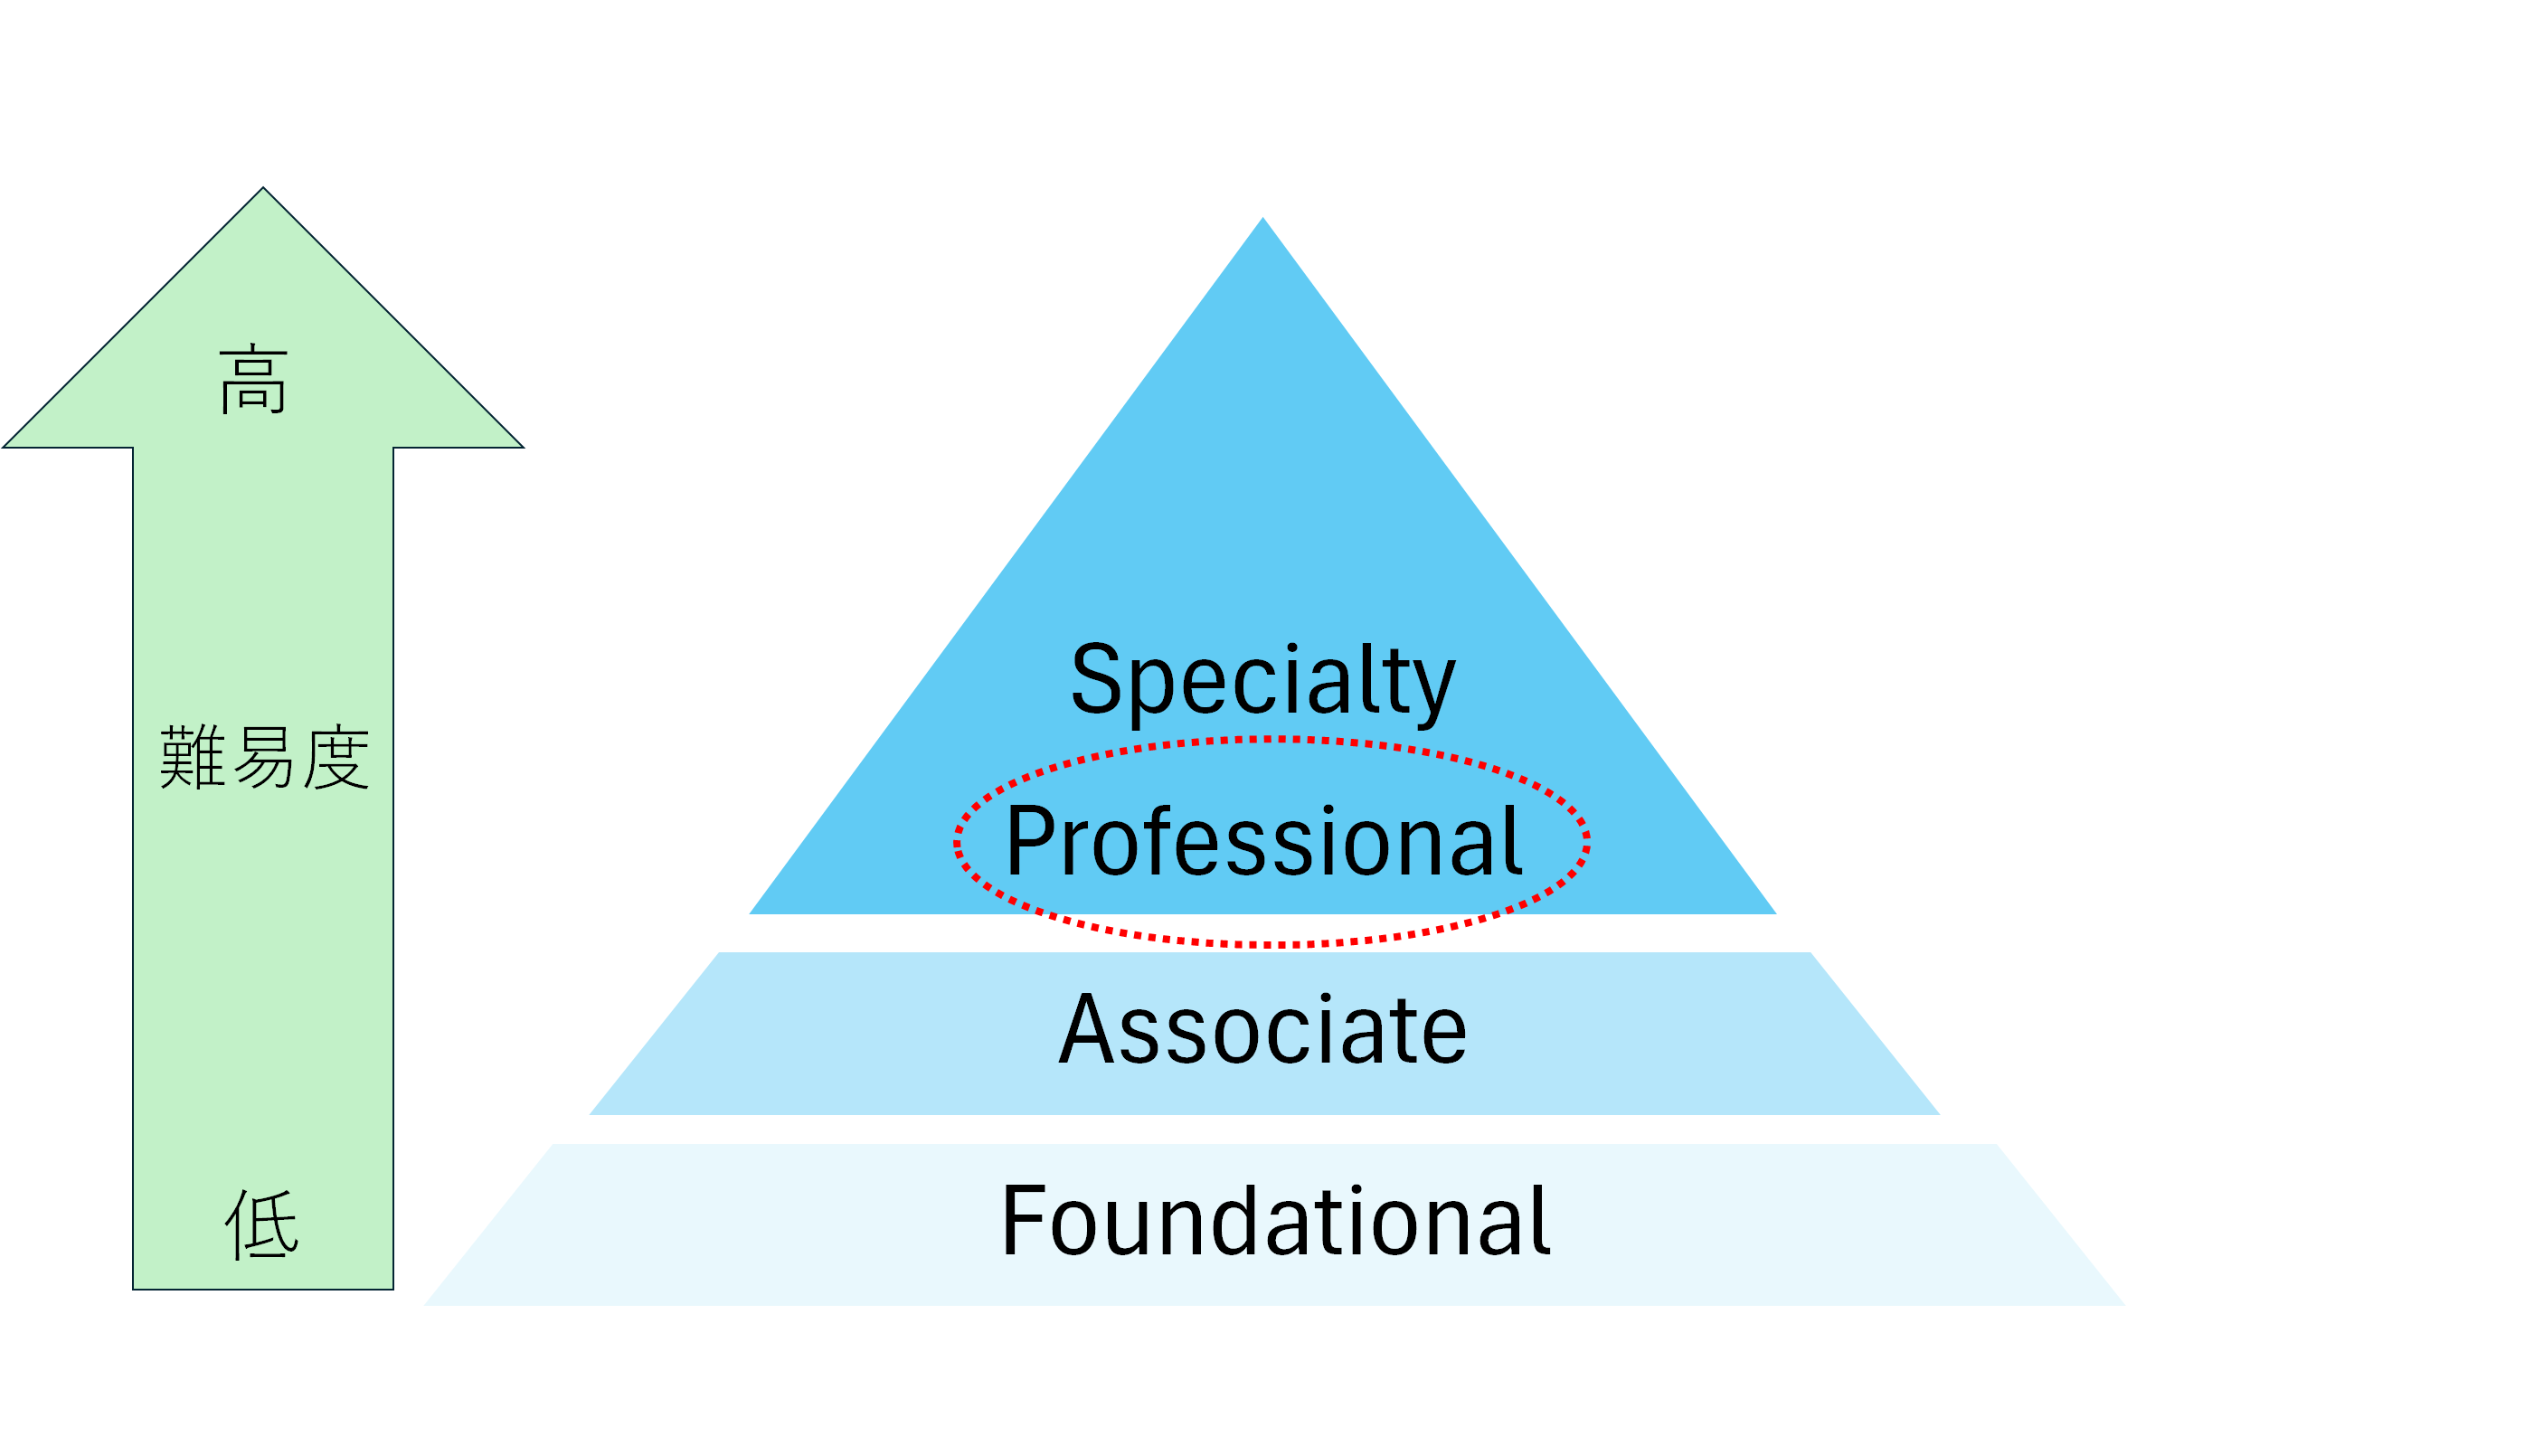
    以下のAWS資格の難易度イメージのとおり難易度が高いです。

    以下、2026/03時点の情報です。最新情報は必ずご確認ください。

     試験名AWS Certified Solutions Architect – Professional (SAP-C02) 試験
    試験時間180分
    出題形式択一選択問題、複数選択問題
    問題数75問 (うち10問は採点対象外)
    合格ライン750(満点は1000)
    試験日随時
    試験場所Pearson VUE テストセンターまたはオンライン監督付き試験
    受験料300 USD ※¥44,000(税込)
    合格発表試験終了後 5 営業日以内
    有効期限3年
    受験要件なし
    再受験ポリシー不合格になった日から 14 日間経過すると、再度受験できます。


    本試験のコンテンツ分野と重み設定は、試験ガイド (SAP-C02)より以下のとおりです。

    • 複雑な組織に対応するソリューションの設計 (採点対象コンテンツの 26%)
    • 新しいソリューションのための設計 (採点対象コンテンツの 29%)
    • 既存のソリューションの継続的な改善 (採点対象コンテンツの 25%)
    • ワークロードの移行とモダナイゼーションの加速 (採点対象コンテンツの 20%)

    使用教材

    教材が多いと手が回らなくなるため、厳選した教材で理解を深めることが重要です。

    ①Webサイト:CloudTech
    他のAWS資格(AWS SCS、AWS MLS)の取得でも使用し、AWS SAP対策でも問題演習としてフル活用しました。

    ✅ おすすめ理由
    ・問題数が多い(※2026年3月時点で299問)
    ・正解/不正解の解説が丁寧

    ✅ 使い方
    ・全問題を複数回解く
    ・間違えた問題は解説を読み込み理解を深める

    ※なお、利用には有料会員登録が必要です(詳細は公式サイト参照)。

    ②書籍:AWS認定資格試験テキスト&問題集 AWS認定ソリューションアーキテクト – プロフェッショナル 改訂第2版
    「体系的に基礎から整理したい方」であれば、まず本書籍を読み込むことをおすすめします。

    図が多く基礎的な知識を身に付けるのに有効です。
    ただし、本書籍で基礎的な知識を身に付けたら問題演習に多くの時間を割くのがおすすめです。

    ある程度知識がある方は、問題演習を先に進めて本書籍は解説を読んで分からなかった点を調べる活用方法もおすすめです。

    勉強期間

    約5か月 ※学習時間141.5h(1~19時間/週×23週)


    1週目〜2週目:情報収集・戦略検討
    ・試験内容や対策方法を調査
    ・学習スケジュールを策定

    3週目〜6週目:基礎知識のインプット
    ・テキストを中心に学習
    ・時間効率のためすべてを完璧に理解するのではなく、知らない部分を重点的に確認

    7週目〜19週目:問題演習メイン
    ・CloudTechで問題演習を実施
    ・理解不足の問題はExcelに記録し、間違えた問題を一覧化
    ・不明点はテキストや検索で補完

    20週目〜23週目:総仕上げ
    ・間違えた問題を中心に復習
    ・弱点の潰し込みと直前対策を実施

    合格するための勉強戦略

    大きく以下の3点を意識して学習を進めました。

    1.モチベーション維持

    難易度の高い試験のため、モチベーション維持が重要です。
    私の場合は徐々に学習時間を増やすことで長時間の学習に慣らしていきました。

    また、通勤時間などの隙間時間を活用し、スマホで学習することで習慣化を意識しました。結果、 日常生活の一部に組み込むことで無理なく継続できました。

    さらに、学習後は意識的にリフレッシュすることで長期的にモチベーションを維持しました。

    可能なかぎり多くの問題について「なぜ正解/不正解か」を説明できる状態を目指しました。

    1問ずつ

    • なぜこの選択肢が適切なのか
    • なぜ他の選択肢では不十分なのか

    を自分の言葉で説明できるまで繰り返し問題を解きました。

    その積み重ねで初見問題や応用問題に対応できるようにしました。

    3.問違えた問題の整理

    CloudTechは問題数が多いため、すべてを同じ優先度で復習するのは非効率です。

    そこで以下のように1問ずつExcelに記入し、復習の優先度を一覧化しました。

    ✅ 優先度:高
    ・不正解だった問題
    ・根拠をまったく説明できない問題

    ✅ 優先度:中
    ・正解したが理解が曖昧な問題

    ✅ 優先度:低
    ・完全に理解できている問題


    そうすることで受験直前期には理解不足の問題を重点的に復習し、効率的に合格率を高めました。

    受験当日

    制限時間残り30分程度残して全問題解ききったため、その後は見直しに充てました。

    問題の難易度として体感としては、完全な初見問題は10問程度で残りはCloudTechの問題演習で触れたパターンの応用が多いと感じました。

    そういった応用問題に対応するには、問題演習で正解/不正解の根拠を立てて考えることが大切であると実感しました。

    受験後の感想

    これまでに取得したスペシャリティ資格と比較すると、AWS SAPは出題されるサービスの範囲が非常に広いと感じました。

    一方で難易度については単純比較が難しいものの、個人的にはスペシャリティ資格(AWS SCS、AWS MLS)よりもイメージしながら理解しやすいと感じる場面もありました。

    これは、スペシャリティ資格のように特定分野の細かい仕様を深く問われるというより、AWS SAPは幅広いサービスの組み合わせや最適解を考える問題が中心であったためです。

    おわりに

    AWS SAPは幅広いサービスの「設計思考」を問われます。

    • 各サービスの使い所を理解する
    • 問題文の意図を正確に読み取る
    • 要件に対して最適な構成を選択する

    この3点を意識して学習を進めることで、合格に近づきます。

    特に重要なのは「なぜその構成になるのか」を自分の言葉で説明できる状態まで理解を深めることです。

    本記事がAWS SAPを目指す方の一助となれば幸いです。

    参考文献